Domain data-blog.de kaufen?
Wir ziehen mit dem Projekt
data-blog.de um.
Sind Sie am Kauf der Domain
data-blog.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain data-blog.de kaufen?
Wie beeinflusst die Datenkonsistenz die Leistung von verteilten Systemen in Bezug auf Datenbanken, Cloud-Computing und Big Data-Anwendungen?
Die Datenkonsistenz beeinflusst die Leistung von verteilten Systemen, da inkonsistente Daten zu Fehlern und Inkonsistenzen in den Anwendungen führen können. In Datenbanken kann eine schlechte Datenkonsistenz zu langsamen Abfragen und ineffizienten Transaktionen führen. Im Cloud-Computing können inkonsistente Daten zu Problemen bei der Skalierbarkeit und Zuverlässigkeit führen. In Big Data-Anwendungen kann eine inkonsistente Datenkonsistenz zu ungenauen Analysen und Entscheidungen führen, die die Leistung der Anwendung beeinträchtigen. **
Wie beeinflusst die Datenkonsistenz die Leistung von verteilten Systemen und welche Strategien können eingesetzt werden, um Datenkonsistenz in verschiedenen Domänen wie Datenbanken, Cloud-Computing und Big Data zu gewährleisten?
Die Datenkonsistenz beeinflusst die Leistung von verteilten Systemen, da inkonsistente Daten zu Fehlern und Inkonsistenzen in den Ergebnissen führen können. In Datenbanken kann die Verwendung von Transaktionen und ACID-Eigenschaften die Datenkonsistenz gewährleisten. Im Cloud-Computing können Replikation und Synchronisationstechniken eingesetzt werden, um die Konsistenz der Daten zu gewährleisten. In Big Data können verteilte Datenverarbeitungsframeworks wie Hadoop und Spark verwendet werden, um die Konsistenz der Daten zu gewährleisten. **

Ähnliche Suchbegriffe für Datenkonsistenz
Top-Angebote
Produkte zum Begriff Datenkonsistenz:
-
HARTING Data-Steckverbinder 09451511100 IP20 RJI Data Plug)Einleitung Der HARTING Data-Steckverbinder 09451511100 ist ein zuverlässiger Steckverbinder für Datenanwendungen in IP20-Umgebungen. Eigenschaften • IP20 Schutzart für den Einsatz in geschützten Umgebungen \n• Gehäuse aus robustem Kunststoff gefertigt \n• Steckgeometrie RJ45 gemäß IEC 60603-7 \n• Geeignet für Adernquerschnitte von 0,22 bis 0,32 qmm, flexibel und massiv \n• Kompatibel mit Kabelmanteldurchmessern von 6,5 bis 6,9 mm \n• EMV-geschützte Ausführung zur Störungsminimierung \n• Betriebstemperaturbereich von -40 bis 70 °C \n• Verriegelungssystem mit spezieller Ausführung \n• Isolierkörper und Kontakte aus hochwertigen Werkstoffen \n• Brennbarkeitsklasse des Isolierstoffs nach UL94 standardisiert Anwendung • Verbindung von Datenleitungen in industriellen Anwendungen \n• Einsatz in Steuerungstechnik und Automatisierungssystemen \n• Verwendung in Werkstätten und Fertigungsanlagen \n• Schutz von Datenverbindungen vor mechanischen Einflüssen bei IP20-Einsatzbedingungen Lieferumfang • 1 x Data-Steckverbinder (09451511100)10,53 €*Versand: 5,95 €Sichere Weiterleitung zum Anbieter

-
Wie beeinflusst die Datenkonsistenz die Leistung von verteilten Systemen und welche Strategien können angewendet werden, um Datenkonsistenz in verschiedenen Domänen wie Datenbanken, Cloud-Computing und Big Data zu gewährleisten?
Die Datenkonsistenz beeinflusst die Leistung von verteilten Systemen, da inkonsistente Daten zu Fehlern und Inkonsistenzen in den Ergebnissen führen können. Um die Datenkonsistenz in verschiedenen Domänen wie Datenbanken, Cloud-Computing und Big Data zu gewährleisten, können Strategien wie Transaktionsmanagement, Replikation, Synchronisation und Konsistenzmodelle angewendet werden. Diese Strategien helfen dabei, sicherzustellen, dass die Daten in verteilten Systemen konsistent und korrekt sind, was wiederum die Leistung und Zuverlässigkeit des Systems verbessert. Es ist wichtig, die geeigneten Strategien basierend auf den Anforderungen und der Art der Daten in der jeweiligen Domäne zu wählen, um eine optimale Datenkonsistenz zu gewährleisten. **
-
Wie funktioniert Big Data?
Wie funktioniert Big Data? **
-
Wie entsteht Big Data?
Big Data entsteht durch die Sammlung und Speicherung einer großen Menge von Daten aus verschiedenen Quellen wie Sensoren, Social Media, Transaktionen und mehr. Diese Daten werden dann mithilfe von speziellen Tools und Technologien analysiert und verarbeitet, um Muster, Trends und Erkenntnisse zu identifizieren. Durch die kontinuierliche Erfassung und Analyse von Daten in Echtzeit können Unternehmen fundierte Entscheidungen treffen und ihre Geschäftsprozesse optimieren. Letztendlich ermöglicht Big Data eine tiefere Einblicke in das Verhalten von Kunden, Trends auf dem Markt und ermöglicht die Entwicklung innovativer Produkte und Dienstleistungen. **
-
Was ist Big Data?
Big Data bezieht sich auf große Mengen an Daten, die mit hoher Geschwindigkeit und Vielfalt generiert werden. Diese Daten können aus verschiedenen Quellen stammen, wie zum Beispiel sozialen Medien, Sensoren oder Transaktionen. Big Data ermöglicht es Unternehmen, Muster und Trends zu identifizieren, um fundierte Entscheidungen zu treffen und ihre Geschäftsprozesse zu optimieren. **
Verdient man Geld beim Praktikum in den Bereichen Data Science oder Machine Learning?
Es hängt von verschiedenen Faktoren ab, ob man Geld während eines Praktikums in den Bereichen Data Science oder Machine Learning verdient. In einigen Fällen bieten Unternehmen Praktikumsstellen mit einer Vergütung an, insbesondere wenn es sich um größere Unternehmen handelt. In anderen Fällen kann es sein, dass Praktika unbezahlt sind oder nur eine geringe Aufwandsentschädigung bieten. Es ist wichtig, die individuellen Bedingungen des Praktikums zu prüfen, um herauszufinden, ob eine Vergütung angeboten wird. **
Wie wichtig ist das Fach Theoretische Informatik für Data Science und Machine Learning?
Das Fach Theoretische Informatik ist für Data Science und Machine Learning nicht unbedingt unverzichtbar, aber es kann dennoch von Vorteil sein. Theoretische Informatik vermittelt grundlegende Konzepte und Algorithmen, die in vielen Bereichen der Informatik relevant sind, einschließlich Data Science und Machine Learning. Ein solides Verständnis der theoretischen Grundlagen kann helfen, komplexe Probleme besser zu verstehen und effiziente Lösungen zu entwickeln. **
Top-Angebote
Produkte zum Begriff Datenkonsistenz:
-
Smoke Factory Data II 2,6KW Fog MachineSmoke Factory Data II 2,6KW Fog Machine, Data II 2,6KW Fog Machine. Die neue Generation der "klassischen" Power- Nebelmaschinen. Digitale Powernebelmaschine mit zwei Pumpen. 230 V/ 2600 W. Externer Ausgang für optionalen Lüfter für max. 800 W, extrem starker Nebelausstoß, Mengenre - gulierung zwischen 1 % und 99 %. DMX, Timer und Schlauchblende serienmäßig. Dauer - nebel bei reduziertem Ausstoß. Achtung: Bitte verwenden Sie nur das original Smoke Factory Fluid. Andere Fluide führen zum Verstopfen des Gerätes und ein GARANTIE Anspruch erlischt in diesem Fall!1225,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
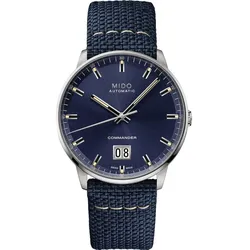
Mido Commander Big Data Herrenuhr M021.626.17.041.00Die Commander Big Date M021.626.17.041.00 von MIDO feiert das 100-jährige Jubiläum der Marke. Ihr großes Datumsfenster bei 6 Uhr bietet unübertroffene Ablesbarkeit. Das satinierte Sonnenschliff-Zifferblatt in Blau, eingefasst in ein elegantes, rundes Gehäuse aus satiniertem Edelstahl und veredelt durch eine polierte Lünette, strahlt schlichte Eleganz aus. Ausgestattet mit dem Kaliber 80, einem automatischen Uhrwerk, bietet diese Uhr eine Gangreserve von bis zu 80 Stunden. Ein transparenter Gehäuseboden und ein Textilarmband mit Kalbsleder und synthetischem Futter runden das Design ab. Großes Datumsfenster bei 6 Uhr Satinierte Sonnenschliff-Zifferblatt in Blau Automatikwerk Mido ETA Kaliber 80 Gangreserve bis zu 80 Stunden Edelstahlgehäuse mit polierter Lünette Wasserdicht bis 5 bar (50 m / 165 ft) Saphirglas Transparenter Gehäuseboden Textilarmband mit Kalbsleder und synthetisch...1020,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
HARTING Data-Steckverbinder 09451511100 IP20 RJI Data Plug)Einleitung Der HARTING Data-Steckverbinder 09451511100 ist ein zuverlässiger Steckverbinder für Datenanwendungen in IP20-Umgebungen. Eigenschaften • IP20 Schutzart für den Einsatz in geschützten Umgebungen \n• Gehäuse aus robustem Kunststoff gefertigt \n• Steckgeometrie RJ45 gemäß IEC 60603-7 \n• Geeignet für Adernquerschnitte von 0,22 bis 0,32 qmm, flexibel und massiv \n• Kompatibel mit Kabelmanteldurchmessern von 6,5 bis 6,9 mm \n• EMV-geschützte Ausführung zur Störungsminimierung \n• Betriebstemperaturbereich von -40 bis 70 °C \n• Verriegelungssystem mit spezieller Ausführung \n• Isolierkörper und Kontakte aus hochwertigen Werkstoffen \n• Brennbarkeitsklasse des Isolierstoffs nach UL94 standardisiert Anwendung • Verbindung von Datenleitungen in industriellen Anwendungen \n• Einsatz in Steuerungstechnik und Automatisierungssystemen \n• Verwendung in Werkstätten und Fertigungsanlagen \n• Schutz von Datenverbindungen vor mechanischen Einflüssen bei IP20-Einsatzbedingungen Lieferumfang • 1 x Data-Steckverbinder (09451511100)10,53 €*Versand: 5,95 €Sichere Weiterleitung zum Anbieter
-
Wie beeinflusst die Datenkonsistenz die Leistung von verteilten Systemen in Bezug auf Datenbanken, Cloud-Computing und Big Data-Anwendungen?
Die Datenkonsistenz beeinflusst die Leistung von verteilten Systemen, da inkonsistente Daten zu Fehlern und Inkonsistenzen in den Anwendungen führen können. In Datenbanken kann eine schlechte Datenkonsistenz zu langsamen Abfragen und ineffizienten Transaktionen führen. Im Cloud-Computing können inkonsistente Daten zu Problemen bei der Skalierbarkeit und Zuverlässigkeit führen. In Big Data-Anwendungen kann eine inkonsistente Datenkonsistenz zu ungenauen Analysen und Entscheidungen führen, die die Leistung der Anwendung beeinträchtigen. **
-
Wie beeinflusst die Datenkonsistenz die Leistung von verteilten Systemen und welche Strategien können eingesetzt werden, um Datenkonsistenz in verschiedenen Domänen wie Datenbanken, Cloud-Computing und Big Data zu gewährleisten?
Die Datenkonsistenz beeinflusst die Leistung von verteilten Systemen, da inkonsistente Daten zu Fehlern und Inkonsistenzen in den Ergebnissen führen können. In Datenbanken kann die Verwendung von Transaktionen und ACID-Eigenschaften die Datenkonsistenz gewährleisten. Im Cloud-Computing können Replikation und Synchronisationstechniken eingesetzt werden, um die Konsistenz der Daten zu gewährleisten. In Big Data können verteilte Datenverarbeitungsframeworks wie Hadoop und Spark verwendet werden, um die Konsistenz der Daten zu gewährleisten. **
-
Wie beeinflusst die Datenkonsistenz die Leistung von verteilten Systemen und welche Strategien können angewendet werden, um Datenkonsistenz in verschiedenen Domänen wie Datenbanken, Cloud-Computing und Big Data zu gewährleisten?
Die Datenkonsistenz beeinflusst die Leistung von verteilten Systemen, da inkonsistente Daten zu Fehlern und Inkonsistenzen in den Ergebnissen führen können. Um die Datenkonsistenz in verschiedenen Domänen wie Datenbanken, Cloud-Computing und Big Data zu gewährleisten, können Strategien wie Transaktionsmanagement, Replikation, Synchronisation und Konsistenzmodelle angewendet werden. Diese Strategien helfen dabei, sicherzustellen, dass die Daten in verteilten Systemen konsistent und korrekt sind, was wiederum die Leistung und Zuverlässigkeit des Systems verbessert. Es ist wichtig, die geeigneten Strategien basierend auf den Anforderungen und der Art der Daten in der jeweiligen Domäne zu wählen, um eine optimale Datenkonsistenz zu gewährleisten. **
-
Wie funktioniert Big Data?
Wie funktioniert Big Data? **
Ähnliche Suchbegriffe für Datenkonsistenz
-
Wie entsteht Big Data?
Big Data entsteht durch die Sammlung und Speicherung einer großen Menge von Daten aus verschiedenen Quellen wie Sensoren, Social Media, Transaktionen und mehr. Diese Daten werden dann mithilfe von speziellen Tools und Technologien analysiert und verarbeitet, um Muster, Trends und Erkenntnisse zu identifizieren. Durch die kontinuierliche Erfassung und Analyse von Daten in Echtzeit können Unternehmen fundierte Entscheidungen treffen und ihre Geschäftsprozesse optimieren. Letztendlich ermöglicht Big Data eine tiefere Einblicke in das Verhalten von Kunden, Trends auf dem Markt und ermöglicht die Entwicklung innovativer Produkte und Dienstleistungen. **
-
Was ist Big Data?
Big Data bezieht sich auf große Mengen an Daten, die mit hoher Geschwindigkeit und Vielfalt generiert werden. Diese Daten können aus verschiedenen Quellen stammen, wie zum Beispiel sozialen Medien, Sensoren oder Transaktionen. Big Data ermöglicht es Unternehmen, Muster und Trends zu identifizieren, um fundierte Entscheidungen zu treffen und ihre Geschäftsprozesse zu optimieren. **
-
Verdient man Geld beim Praktikum in den Bereichen Data Science oder Machine Learning?
Es hängt von verschiedenen Faktoren ab, ob man Geld während eines Praktikums in den Bereichen Data Science oder Machine Learning verdient. In einigen Fällen bieten Unternehmen Praktikumsstellen mit einer Vergütung an, insbesondere wenn es sich um größere Unternehmen handelt. In anderen Fällen kann es sein, dass Praktika unbezahlt sind oder nur eine geringe Aufwandsentschädigung bieten. Es ist wichtig, die individuellen Bedingungen des Praktikums zu prüfen, um herauszufinden, ob eine Vergütung angeboten wird. **
-
Wie wichtig ist das Fach Theoretische Informatik für Data Science und Machine Learning?
Das Fach Theoretische Informatik ist für Data Science und Machine Learning nicht unbedingt unverzichtbar, aber es kann dennoch von Vorteil sein. Theoretische Informatik vermittelt grundlegende Konzepte und Algorithmen, die in vielen Bereichen der Informatik relevant sind, einschließlich Data Science und Machine Learning. Ein solides Verständnis der theoretischen Grundlagen kann helfen, komplexe Probleme besser zu verstehen und effiziente Lösungen zu entwickeln. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.