Domain data-blog.de kaufen?
Wir ziehen mit dem Projekt
data-blog.de um.
Sind Sie am Kauf der Domain
data-blog.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain data-blog.de kaufen?
Wie funktioniert Big Data?
Wie funktioniert Big Data? **
Wie entsteht Big Data?
Big Data entsteht durch die Sammlung und Speicherung einer großen Menge von Daten aus verschiedenen Quellen wie Sensoren, Social Media, Transaktionen und mehr. Diese Daten werden dann mithilfe von speziellen Tools und Technologien analysiert und verarbeitet, um Muster, Trends und Erkenntnisse zu identifizieren. Durch die kontinuierliche Erfassung und Analyse von Daten in Echtzeit können Unternehmen fundierte Entscheidungen treffen und ihre Geschäftsprozesse optimieren. Letztendlich ermöglicht Big Data eine tiefere Einblicke in das Verhalten von Kunden, Trends auf dem Markt und ermöglicht die Entwicklung innovativer Produkte und Dienstleistungen. **


Ähnliche Suchbegriffe für An-Introduction-to-Statistical
Top-Angebote
Produkte zum Begriff An-Introduction-to-Statistical:
-
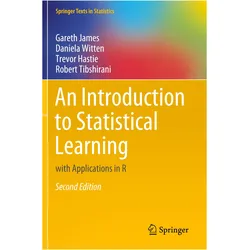
James, Gareth: An Introduction to Statistical LearningAn Introduction to Statistical Learning , with Applications in R , Blattfeder > Sportfederung , Auflage: 2. Auflage, Erscheinungsjahr: 20210824, Produktform: Leinen, Titel der Reihe: Springer Texts in Statistics##, Autoren: James, Gareth~Witten, Daniela~Hastie, Trevor~Tibshirani, Robert, Auflage: 21002, Auflage/Ausgabe: 2. Auflage, Seitenzahl/Blattzahl: 607, Abbildungen: 4 schwarz-weiße und 138 farbige Abbildungen, 10 schwarz-weiße Tabellen, Themenüberschrift: MATHEMATICS / Probability & Statistics / General, Keyword: R;R software;data mining;inference;statistical learning;supervised learning;unsupervised learning, Fachschema: Mathematik / Statistik~Programmiersprachen~Statistik~Roboter - Robotik - Industrieroboter~Datenverarbeitung / Anwendungen / Mathematik, Statistik~Intelligenz / Künstliche Intelligenz~KI~Künstliche Intelligenz - AI, Fachkategorie: Wahrscheinlichkeitsrechnung und Statistik~Mathematische und statistische Software~Programmier- und Skriptsprachen, allgemein~Künstliche Intelligenz, Bildungszweck: für die Hochschule, Warengruppe: HC/Mathematik/Wahrscheinlichkeitstheorie, Fachkategorie: Robotik, Thema: Verstehen, Text Sprache: eng, Seitenanzahl: XV, Seitenanzahl: 607, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Verlag: Springer-Verlag GmbH, Verlag: Springer-Verlag GmbH, Verlag: Springer US, New York, N.Y., Länge: 160, Breite: 240, Höhe: 31, Gewicht: 1010, Produktform: Gebunden, Genre: Importe, Genre: Importe, Herkunftsland: VEREINIGTE STAATEN VON AMERIKA (US), Katalog: LIB_ENBOOK, Katalog: Gesamtkatalog, Katalog: Internationale Lagertitel, Katalog: internationale Titel, Katalog: Lagerartikel, Book on Demand, ausgew. Medienartikel, Relevanz: 0004, Tendenz: -1, Unterkatalog: AK, Unterkatalog: Bücher, Unterkatalog: Hardcover, Unterkatalog: Lagerartikel, WolkenId: 278877279,17 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
An Introduction to Statistical Learning, Fachbücher von Daniela Witten, Robert Tibshirani, Gareth James, Trevor HastieEine Einführung in das statistische Lernen bietet einen zugänglichen Überblick über das Gebiet des statistischen Lernens, ein unverzichtbares Werkzeug, um die umfangreichen und komplexen Datensätze zu verstehen, die in den letzten zwanzig Jahren in Bereichen wie Biologie, Finanzen, Marketing und Astrophysik entstanden sind. Dieses Buch präsentiert einige der wichtigsten Modellierungs- und Vorhersagetechniken sowie relevante Anwendungen. Zu den Themen gehören lineare Regression, Klassifikation, Resampling-Methoden, Shrinkage-Ansätze, baumbasierte Methoden, Support-Vektor-Maschinen, Clustering, Deep Learning, Überlebensanalyse, multiple Tests und mehr. Farbige Grafiken und Beispiele aus der Praxis werden verwendet, um die vorgestellten Methoden zu veranschaulichen. Da das Ziel dieses Lehrbuchs darin besteht, die Anwendung dieser statistischen Lerntechniken für Praktiker in Wissenschaft, Industrie und anderen Bereichen zu erleichtern, enthält jedes Kapitel ein Tutorial zur Implementierung der in R präsentierten Analysen und Methoden, einer äusserst beliebten Open-Source-Statistiksoftware. Zwei der Autoren haben gemeinsam "The Elements of Statistical Learning" verfasst, ein beliebtes Nachschlagewerk für Statistiker und Forscher im Bereich maschinelles Lernen. "Eine Einführung in das statistische Lernen" behandelt viele der gleichen Themen, jedoch auf einem Niveau, das für ein viel breiteres Publikum zugänglich ist. Dieses Buch richtet sich sowohl an Statistiker als auch an Nicht-Statistiker, die moderne statistische Lerntechniken zur Analyse ihrer Daten nutzen möchten. Der Text setzt lediglich einen vorherigen Kurs in linearer Regression und kein Wissen über Matrizenalgebra voraus. Diese zweite Auflage enthält neue Kapitel über Deep Learning, Überlebensanalyse und multiple Tests sowie erweiterte Behandlungen von naïvem Bayes, verallgemeinerten linearen Modellen, bayesianischen additiven Regressionsbäumen und Matrixvollständigung. Der R-Code wurde durchgängig aktualisiert, um die Kompatibilität sicherzustellen.58,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter



-
Was ist Big Data?
Big Data bezieht sich auf große Mengen an Daten, die mit hoher Geschwindigkeit und Vielfalt generiert werden. Diese Daten können aus verschiedenen Quellen stammen, wie zum Beispiel sozialen Medien, Sensoren oder Transaktionen. Big Data ermöglicht es Unternehmen, Muster und Trends zu identifizieren, um fundierte Entscheidungen zu treffen und ihre Geschäftsprozesse zu optimieren. **
-
Verdient man Geld beim Praktikum in den Bereichen Data Science oder Machine Learning?
Es hängt von verschiedenen Faktoren ab, ob man Geld während eines Praktikums in den Bereichen Data Science oder Machine Learning verdient. In einigen Fällen bieten Unternehmen Praktikumsstellen mit einer Vergütung an, insbesondere wenn es sich um größere Unternehmen handelt. In anderen Fällen kann es sein, dass Praktika unbezahlt sind oder nur eine geringe Aufwandsentschädigung bieten. Es ist wichtig, die individuellen Bedingungen des Praktikums zu prüfen, um herauszufinden, ob eine Vergütung angeboten wird. **
-
Wie wichtig ist das Fach Theoretische Informatik für Data Science und Machine Learning?
Das Fach Theoretische Informatik ist für Data Science und Machine Learning nicht unbedingt unverzichtbar, aber es kann dennoch von Vorteil sein. Theoretische Informatik vermittelt grundlegende Konzepte und Algorithmen, die in vielen Bereichen der Informatik relevant sind, einschließlich Data Science und Machine Learning. Ein solides Verständnis der theoretischen Grundlagen kann helfen, komplexe Probleme besser zu verstehen und effiziente Lösungen zu entwickeln. **
-
Was bedeutet Introduction auf Deutsch?
Was bedeutet Introduction auf Deutsch? Introduction bedeutet auf Deutsch "Einführung" oder "Einleitung". Es handelt sich um den ersten Teil eines Textes oder einer Präsentation, in dem das Thema vorgestellt und eingeführt wird. Die Introduction dient dazu, den Leser oder Zuhörer auf das Thema einzustimmen und einen Überblick über den Inhalt zu geben. In wissenschaftlichen Arbeiten ist die Introduction oft auch mit einer Problemstellung oder Forschungsfrage verbunden. **


Was kommt in eine Introduction?
In eine Introduction kommen normalerweise Informationen darüber, worum es in dem Text oder der Arbeit geht. Es werden die Hauptthemen oder Argumente vorgestellt, die im weiteren Verlauf behandelt werden. Oft wird auch der Kontext oder die Relevanz des Themas für die Leserinnen und Leser erläutert. Außerdem kann eine Einleitung dazu dienen, das Interesse der Leserinnen und Leser zu wecken und sie auf den Text vorzubereiten. Es ist wichtig, dass die Introduction prägnant und klar formuliert ist, um einen guten ersten Eindruck zu hinterlassen. **
Was ist der Unterschied zwischen Big Data und Smart Data?
Big Data bezieht sich auf große Mengen von Daten, die aus verschiedenen Quellen stammen und oft unstrukturiert sind. Smart Data hingegen bezieht sich auf die Analyse und Nutzung dieser Daten, um wertvolle Erkenntnisse und Handlungsempfehlungen zu generieren. Smart Data konzentriert sich auf die Auswahl und Verarbeitung relevanter Daten, um konkrete Probleme zu lösen oder Entscheidungen zu unterstützen. **
Top-Angebote
Produkte zum Begriff An-Introduction-to-Statistical:
-
James, Gareth: An Introduction to Statistical LearningAn Introduction to Statistical Learning , with Applications in R , Blattfeder > Sportfederung , Auflage: 2. Auflage, Erscheinungsjahr: 20210824, Produktform: Leinen, Titel der Reihe: Springer Texts in Statistics##, Autoren: James, Gareth~Witten, Daniela~Hastie, Trevor~Tibshirani, Robert, Auflage: 21002, Auflage/Ausgabe: 2. Auflage, Seitenzahl/Blattzahl: 607, Abbildungen: 4 schwarz-weiße und 138 farbige Abbildungen, 10 schwarz-weiße Tabellen, Themenüberschrift: MATHEMATICS / Probability & Statistics / General, Keyword: R;R software;data mining;inference;statistical learning;supervised learning;unsupervised learning, Fachschema: Mathematik / Statistik~Programmiersprachen~Statistik~Roboter - Robotik - Industrieroboter~Datenverarbeitung / Anwendungen / Mathematik, Statistik~Intelligenz / Künstliche Intelligenz~KI~Künstliche Intelligenz - AI, Fachkategorie: Wahrscheinlichkeitsrechnung und Statistik~Mathematische und statistische Software~Programmier- und Skriptsprachen, allgemein~Künstliche Intelligenz, Bildungszweck: für die Hochschule, Warengruppe: HC/Mathematik/Wahrscheinlichkeitstheorie, Fachkategorie: Robotik, Thema: Verstehen, Text Sprache: eng, Seitenanzahl: XV, Seitenanzahl: 607, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Verlag: Springer-Verlag GmbH, Verlag: Springer-Verlag GmbH, Verlag: Springer US, New York, N.Y., Länge: 160, Breite: 240, Höhe: 31, Gewicht: 1010, Produktform: Gebunden, Genre: Importe, Genre: Importe, Herkunftsland: VEREINIGTE STAATEN VON AMERIKA (US), Katalog: LIB_ENBOOK, Katalog: Gesamtkatalog, Katalog: Internationale Lagertitel, Katalog: internationale Titel, Katalog: Lagerartikel, Book on Demand, ausgew. Medienartikel, Relevanz: 0004, Tendenz: -1, Unterkatalog: AK, Unterkatalog: Bücher, Unterkatalog: Hardcover, Unterkatalog: Lagerartikel, WolkenId: 278877279,17 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Wie funktioniert Big Data?
Wie funktioniert Big Data? **
-
Wie entsteht Big Data?
Big Data entsteht durch die Sammlung und Speicherung einer großen Menge von Daten aus verschiedenen Quellen wie Sensoren, Social Media, Transaktionen und mehr. Diese Daten werden dann mithilfe von speziellen Tools und Technologien analysiert und verarbeitet, um Muster, Trends und Erkenntnisse zu identifizieren. Durch die kontinuierliche Erfassung und Analyse von Daten in Echtzeit können Unternehmen fundierte Entscheidungen treffen und ihre Geschäftsprozesse optimieren. Letztendlich ermöglicht Big Data eine tiefere Einblicke in das Verhalten von Kunden, Trends auf dem Markt und ermöglicht die Entwicklung innovativer Produkte und Dienstleistungen. **
-
Was ist Big Data?
Big Data bezieht sich auf große Mengen an Daten, die mit hoher Geschwindigkeit und Vielfalt generiert werden. Diese Daten können aus verschiedenen Quellen stammen, wie zum Beispiel sozialen Medien, Sensoren oder Transaktionen. Big Data ermöglicht es Unternehmen, Muster und Trends zu identifizieren, um fundierte Entscheidungen zu treffen und ihre Geschäftsprozesse zu optimieren. **
-
Verdient man Geld beim Praktikum in den Bereichen Data Science oder Machine Learning?
Es hängt von verschiedenen Faktoren ab, ob man Geld während eines Praktikums in den Bereichen Data Science oder Machine Learning verdient. In einigen Fällen bieten Unternehmen Praktikumsstellen mit einer Vergütung an, insbesondere wenn es sich um größere Unternehmen handelt. In anderen Fällen kann es sein, dass Praktika unbezahlt sind oder nur eine geringe Aufwandsentschädigung bieten. Es ist wichtig, die individuellen Bedingungen des Praktikums zu prüfen, um herauszufinden, ob eine Vergütung angeboten wird. **
Ähnliche Suchbegriffe für An-Introduction-to-Statistical
-
An Introduction to Statistical Learning, Fachbücher von Daniela Witten, Robert Tibshirani, Gareth James, Trevor HastieEine Einführung in das statistische Lernen bietet einen zugänglichen Überblick über das Gebiet des statistischen Lernens, ein unverzichtbares Werkzeug, um die umfangreichen und komplexen Datensätze zu verstehen, die in den letzten zwanzig Jahren in Bereichen wie Biologie, Finanzen, Marketing und Astrophysik entstanden sind. Dieses Buch präsentiert einige der wichtigsten Modellierungs- und Vorhersagetechniken sowie relevante Anwendungen. Zu den Themen gehören lineare Regression, Klassifikation, Resampling-Methoden, Shrinkage-Ansätze, baumbasierte Methoden, Support-Vektor-Maschinen, Clustering, Deep Learning, Überlebensanalyse, multiple Tests und mehr. Farbige Grafiken und Beispiele aus der Praxis werden verwendet, um die vorgestellten Methoden zu veranschaulichen. Da das Ziel dieses Lehrbuchs darin besteht, die Anwendung dieser statistischen Lerntechniken für Praktiker in Wissenschaft, Industrie und anderen Bereichen zu erleichtern, enthält jedes Kapitel ein Tutorial zur Implementierung der in R präsentierten Analysen und Methoden, einer äusserst beliebten Open-Source-Statistiksoftware. Zwei der Autoren haben gemeinsam "The Elements of Statistical Learning" verfasst, ein beliebtes Nachschlagewerk für Statistiker und Forscher im Bereich maschinelles Lernen. "Eine Einführung in das statistische Lernen" behandelt viele der gleichen Themen, jedoch auf einem Niveau, das für ein viel breiteres Publikum zugänglich ist. Dieses Buch richtet sich sowohl an Statistiker als auch an Nicht-Statistiker, die moderne statistische Lerntechniken zur Analyse ihrer Daten nutzen möchten. Der Text setzt lediglich einen vorherigen Kurs in linearer Regression und kein Wissen über Matrizenalgebra voraus. Diese zweite Auflage enthält neue Kapitel über Deep Learning, Überlebensanalyse und multiple Tests sowie erweiterte Behandlungen von naïvem Bayes, verallgemeinerten linearen Modellen, bayesianischen additiven Regressionsbäumen und Matrixvollständigung. Der R-Code wurde durchgängig aktualisiert, um die Kompatibilität sicherzustellen.58,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Wie wichtig ist das Fach Theoretische Informatik für Data Science und Machine Learning?
Das Fach Theoretische Informatik ist für Data Science und Machine Learning nicht unbedingt unverzichtbar, aber es kann dennoch von Vorteil sein. Theoretische Informatik vermittelt grundlegende Konzepte und Algorithmen, die in vielen Bereichen der Informatik relevant sind, einschließlich Data Science und Machine Learning. Ein solides Verständnis der theoretischen Grundlagen kann helfen, komplexe Probleme besser zu verstehen und effiziente Lösungen zu entwickeln. **
-
Was bedeutet Introduction auf Deutsch?
Was bedeutet Introduction auf Deutsch? Introduction bedeutet auf Deutsch "Einführung" oder "Einleitung". Es handelt sich um den ersten Teil eines Textes oder einer Präsentation, in dem das Thema vorgestellt und eingeführt wird. Die Introduction dient dazu, den Leser oder Zuhörer auf das Thema einzustimmen und einen Überblick über den Inhalt zu geben. In wissenschaftlichen Arbeiten ist die Introduction oft auch mit einer Problemstellung oder Forschungsfrage verbunden. **
-
Was kommt in eine Introduction?
In eine Introduction kommen normalerweise Informationen darüber, worum es in dem Text oder der Arbeit geht. Es werden die Hauptthemen oder Argumente vorgestellt, die im weiteren Verlauf behandelt werden. Oft wird auch der Kontext oder die Relevanz des Themas für die Leserinnen und Leser erläutert. Außerdem kann eine Einleitung dazu dienen, das Interesse der Leserinnen und Leser zu wecken und sie auf den Text vorzubereiten. Es ist wichtig, dass die Introduction prägnant und klar formuliert ist, um einen guten ersten Eindruck zu hinterlassen. **
-
Was ist der Unterschied zwischen Big Data und Smart Data?
Big Data bezieht sich auf große Mengen von Daten, die aus verschiedenen Quellen stammen und oft unstrukturiert sind. Smart Data hingegen bezieht sich auf die Analyse und Nutzung dieser Daten, um wertvolle Erkenntnisse und Handlungsempfehlungen zu generieren. Smart Data konzentriert sich auf die Auswahl und Verarbeitung relevanter Daten, um konkrete Probleme zu lösen oder Entscheidungen zu unterstützen. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.